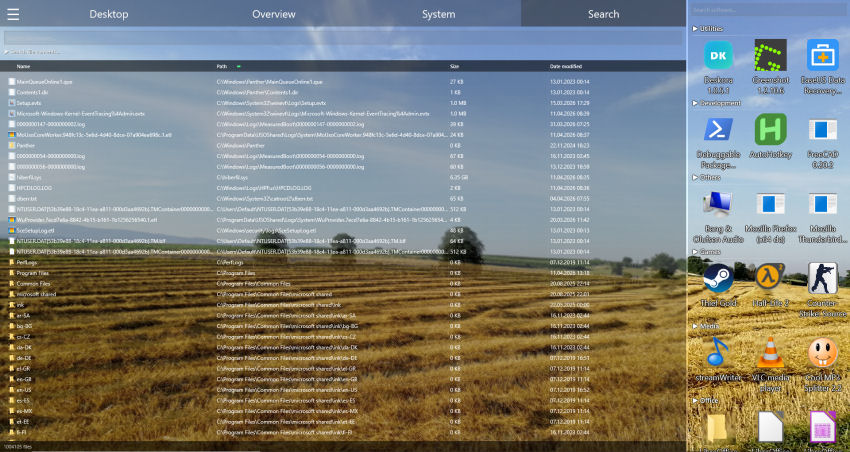
Por que seus documentos ficam invisíveis
O texto de um PDF não fica salvo como texto puro: ele está em fluxos de conteúdo compactados, codificados fonte por fonte. Desde 2007 os arquivos do Office são contêineres ZIP com XML compactado dentro. Uma pesquisa que lê os bytes brutos desses arquivos não encontra nada, por princípio — e é por isso que tanta gente tem certeza de que um documento “não está neste computador” quando ele esteve lá o tempo todo.
- PDF — o texto está em fluxos compactados com FlateDecode
- DOCX, XLSX, PPTX — contêineres ZIP com XML compactado
- ODT, ODS, ODP — o mesmo princípio, outro XML
- Pesquisa do Windows — indexa apenas pastas escolhidas e ignora unidades inteiras
📄 Encontrar o documento, não apenas o nome do arquivo
O Deskora pesquisa dentro de PDF, Word, Excel, PowerPoint e OpenDocument — em todas as unidades locais.
Baixar o Deskora grátisQue formatos são pesquisados
O Deskora extrai o texto legível de um documento e pesquisa nele. Isto é o que está coberto — e o que deliberadamente não está.
| Formato | O que é pesquisado |
|---|---|
| PDF (.pdf) | Texto completo das páginas, incluindo fluxos compactados e fontes CID. O número da página é indicado. |
| Word (.docx, .docm) | Corpo do texto, tabelas, cabeçalhos, rodapés e notas. O texto excluído no controle de alterações fica de fora. |
| Excel (.xlsx, .xlsm) | Todas as células de todas as planilhas. O nome da planilha é indicado. |
| PowerPoint (.pptx, .ppsx) | Todo o texto dos slides, em ordem. O número do slide é indicado. |
| OpenDocument (.odt) | Texto completo, incluindo títulos e tabelas. |
| OpenDocument (.ods) | Todas as células de todas as tabelas. O nome da tabela é indicado. |
| OpenDocument (.odp) | Todo o texto dos slides. O nome do slide é indicado. |
| RTF (.rtf) | Texto completo, com palavras de controle e códigos de caracteres resolvidos. |
| TXT, LOG, CSV, XML, JSON | Pesquisado diretamente, byte a byte — o caminho rápido, inalterado. |
| .doc, .xls, .msg | Não suportados. Os formatos binários antigos e os contêineres de e-mail são um tema à parte e ficam de fora de propósito, em vez de serem feitos pela metade. |
Como funciona
A extração é cara, por isso acontece uma única vez. Depois o texto fica compactado no índice e cada pesquisa seguinte parece uma pesquisa em texto simples.
🔍 Extração de texto
Os fluxos PDF são descompactados e decodificados por meio das tabelas de fontes; os arquivos do Office são descompactados e seu XML é analisado corretamente — entidades e separação de parágrafos incluídas.
💾 Índice persistente
O texto extraído é salvo compactado. Só é extraído de novo se o tamanho ou a data do arquivo mudarem.
🌙 Construção discreta
Prioridade mínima de thread e de entrada/saída, cancelável a qualquer momento. Você nem vai notar.
📄 Localizações reais
Um resultado indica a página 7, a planilha “Receita” ou o slide 3 — não um número de linha sem significado.
O Deskora em comparação
Comparação honesta. O Deskora é um software de desktop gratuito, não uma plataforma jurídica de e-discovery — e não finge ser.
| Deskora | Pesquisa do Windows | Agent Ransack | dtSearch | |
|---|---|---|---|---|
| Pesquisa dentro de PDF | Sim | Só pastas indexadas | Sim | Sim |
| Pesquisa dentro de arquivos do Office | Sim | Só pastas indexadas | Sim | Sim |
| Abrange todas as unidades locais | Sim | Não | Sim | Sim |
| Expressões regulares | Sim | Não | Sim | Sim |
| Indica página / planilha / slide | Sim | Não | Não | Sim |
| Preço | Grátis | Incluído | Grátis / pago | Licença comercial paga |
Para quem foi feito
⚖️ Escritórios de advocacia e contabilidade
Um número de processo aparece no cabeçalho de um PDF, na terceira aba de uma planilha e num contrato escaneado. Pelo nome do arquivo você não encontra nenhum. Pelo conteúdo, encontra os três — com a página que é preciso abrir.
🔬 Pesquisa acadêmica e estudo
Centenas de artigos, dezenas de conjuntos de dados, anotações em três formatos. “Em que artigo estava aquele método?” é uma pergunta de conteúdo e deveria levar um segundo, não uma tarde.
🔧 Documentação técnica
Os números de peça e os códigos de erro estão dentro dos manuais, não nos nomes dos arquivos. Uma pesquisa que lê lá dentro transforma uma pasta de PDF numa base de conhecimento.
Seus documentos ficam no seu computador
A extração roda inteiramente no seu computador. Nada é enviado para a nuvem ou para um servidor, e não é preciso conta. O índice de documentos pode ser desligado por completo, limitado a pastas escolhidas ou receber exclusões — um programa que conhece todas as unidades locais tem que deixar você traçar o limite.
Perguntas frequentes
Encontra texto em PDFs escaneados?
Não. Um PDF escaneado é uma imagem de texto, não texto. Seria preciso reconhecimento ótico, que é outro tipo de programa. O Deskora indicará simplesmente que não há resultados em vez de fingir.
E os arquivos protegidos por senha?
São ignorados. O Deskora não tenta quebrar a criptografia, nem mesmo no caso comum de senha de usuário vazia: alguém colocou esse bloqueio de propósito.
Isso deixa o computador lento?
O índice é construído em segundo plano com a prioridade mais baixa e pode ser cancelado a qualquer momento. A pesquisa em texto simples fica inalterada: continua trabalhando diretamente sobre o arquivo, sem cópia.
Quanto espaço ocupa o índice?
O texto extraído é salvo compactado e ocupa uma fração dos documentos. Alguns milhares de documentos costumam ocupar algumas dezenas de megabytes.
Funciona com escritas não latinas?
Sim. Chinês, japonês, cirílico, árabe e devanágari são processados, e a pesquisa sem distinção de maiúsculas funciona além do ASCII.
Posso usar expressões regulares?
Sim, em sintaxe ECMAScript. Uma expressão inválida mostra um aviso junto ao campo em vez de falhar em silêncio.
📄 Encontrar o documento, não apenas o nome do arquivo
O Deskora pesquisa dentro de PDF, Word, Excel, PowerPoint e OpenDocument — em todas as unidades locais.
Baixar o Deskora grátis